搜索结果都找对了,为什么读者还是觉得不好用?常见原因是最有帮助的资料排在最后,只提到几个关键词的内容却占了第一位。Precision 和 Recall 能检查找到了多少相关资料,却不能完整解释这些资料摆放的位置。
本文用五条虚构的帮助中心资料,说明 NDCG@3 怎样评价前三条结果的排列质量。你会得到一份相关性标注、一段只用 Python 标准库的计算脚本,以及比较两个排序方案的验收记录。练习不调用模型、不购买接口,也没有进行真实搜索系统的线上实验。
一、先明确这个指标解决什么问题
假设用户搜索“如何修改已提交的报名信息”。候选资料中,有的直接给出修改入口和截止条件,有的只介绍报名流程,还有的讲完全不同的活动。把最直接的答案放在前面,通常比仅仅把它放进候选集合更有价值。
NDCG 的中文名称是归一化折损累计增益。先把文档的相关性分值按展示位置打折后相加,得到 DCG;再除以同一批候选资料在理想顺序下的 DCG,得到归一化结果。位置越靠后,同样的相关性贡献越小。
这里的“理想”来自人工标注,不是模型自己声称的理想答案。如果相关性标准写错了,算术再准确也会稳定地奖励错误目标。因此先准备标注规则,再看指标公式,顺序不能反过来。
本例使用非负的零到三级相关性,并采用线性增益:分值三就贡献三,不转换成指数增益。不同实现也可能选择指数形式,不能在没有说明的情况下比较两套数字。本文口径与 scikit-learn 文档描述的直接使用真实相关性分值的方式一致。
二、准备问题、资料和标注表
建立一个空练习目录 ranking-lab。电脑需要能运行 Python 3,执行 python --version 确认;不需要安装 scikit-learn,本文计算只用标准库。若系统使用 py 启动器,就把后续命令中的 python 替换为已确认的启动命令。
先固定问题:“报名已经提交,如何修改联系电话,是否有截止时间?”下面五条均为教学用虚构资料,不代表本站或任何真实平台的办事规则。
- A:修改入口、联系电话字段和修改截止时间都明确,相关性为三。
- B:解释提交后如何申请修改,但没有覆盖截止条件,相关性为二。
- C:只说明报名时需要填写联系电话,相关性为一。
- D:介绍另一项活动的报名宣传,相关性为零。
- E:仅列场地交通信息,相关性为零。
三级表示能直接完成问题的关键步骤,二级表示有实质帮助但仍缺重要条件,一级表示背景相关,零级表示对当前问题无帮助。标注应根据资料正文,而非标题里有没有“报名”两个字。
如果两位编辑对 B 的级别意见不同,先写下缺失条件与判断依据,再讨论统一。不要因为某个排序器把 B 排得很高,就提高 B 的标注分数;这会让评测失去独立性。资料更新后应重新检查相关性,旧标签不能永久当作事实。
三、比较两个候选排序
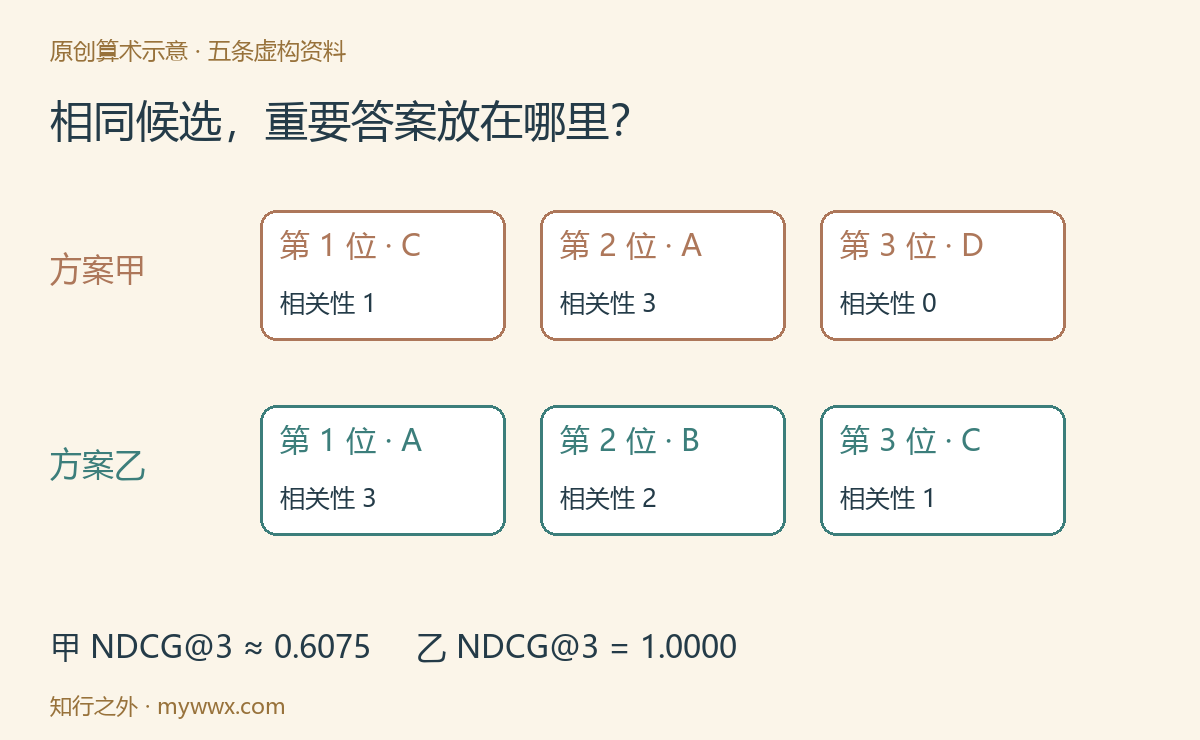
方案甲的前三条是 C、A、D,方案乙是 A、B、C。两者候选全集都是 A 到 E,本例在同一个问题、同一个候选范围和同一个 k 下比较。甲的完整顺序写为 C、A、D、B、E,乙为 A、B、C、D、E,便于保留证据。
先不要看公式,尝试从使用者角度阅读:甲的第一条只是填表背景,第二条才有直接答案,第三条不相关;乙先给直接答案,再给补充过程与背景。这个练习预期乙优于甲,指标应能反映这一点。
不要混淆两个层次:排序器先从很多资料中召回候选,再给候选排序。如果 A 根本没被召回,重排序器无法凭空把 A 放到第一位。本文先固定五条候选,只检查排列;生产评测还要另外检查候选是否完整。
四、手算 DCG 与理想分数
本文采用的折扣为:第 i 位除以 log2(i + 1),位置从一开始计数。因此第一位分母为一,第二位约为一点五八五,第三位为二。不要把数组下标从零开始直接放进公式,否则会遇到错误的分母。
甲的相关性序列是“一、三、零”。计算为一除以一,加三除以 log2(3),再加零除以二,约为二点八九二八。乙的序列是“三、二、一”,约为三,加一点二六一九,再加零点五,合计约四点七六一九。
理想顺序按标注分数从高到低排列,在这里就是三、二、一。因此理想 DCG@3 也约为四点七六一九。甲的 NDCG@3 约为零点六零七五,乙为一。
这不表示乙满足了百分之百的用户需求,也不表示上线后满意度一定提高。一只表示在本次候选、标注和计算口径下,前三条达到了理想排列。真实任务还涉及资料准确性、权限、时效以及页面能否实际操作。
五、写一个透明的离线计算器
将下面代码保存为 ranking_check.py,使用 UTF-8 编码。输入只接受本例已经人工排列的文档编号,不直接接受模型相似度分数,因此没有预测分数并列时如何平均的歧义。代码拒绝未知编号和重复结果,避免让同一条好资料反复占位刷高分数。
from math import log2

labels = {"A": 3, "B": 2, "C": 1, "D": 0, "E": 0}

def ndcg_at_k(order, labels, k=3):
    if type(k) is not int or k < 1:
        raise ValueError("k 必须是正整数")
    if len(order) != len(set(order)):
        raise ValueError("排序中出现重复文档")
    if any(doc not in labels for doc in order):
        raise ValueError("存在未标注文档")
    if any(type(v) is not int or v < 0 for v in labels.values()):
        raise ValueError("本例要求非负整数相关性")
    def dcg(values):
        return sum(value / log2(i + 2)
                   for i, value in enumerate(values[:k]))
    ideal = dcg(sorted(labels.values(), reverse=True))
    if ideal == 0:
        return None
    actual = dcg([labels[doc] for doc in order])
    return actual / ideal

for name, order in {
    "甲": ["C", "A", "D", "B", "E"],
    "乙": ["A", "B", "C", "D", "E"],
}.items():
    value = ndcg_at_k(order, labels)
    print(name, f"{value:.4f}")
运行 python ranking_check.py。本例甲应输出 0.6075,乙为 1.0000。小数只在最终显示时格式化,不能先把各位置折扣舍入再累加,否则不同工具的结果可能出现不必要的差异。
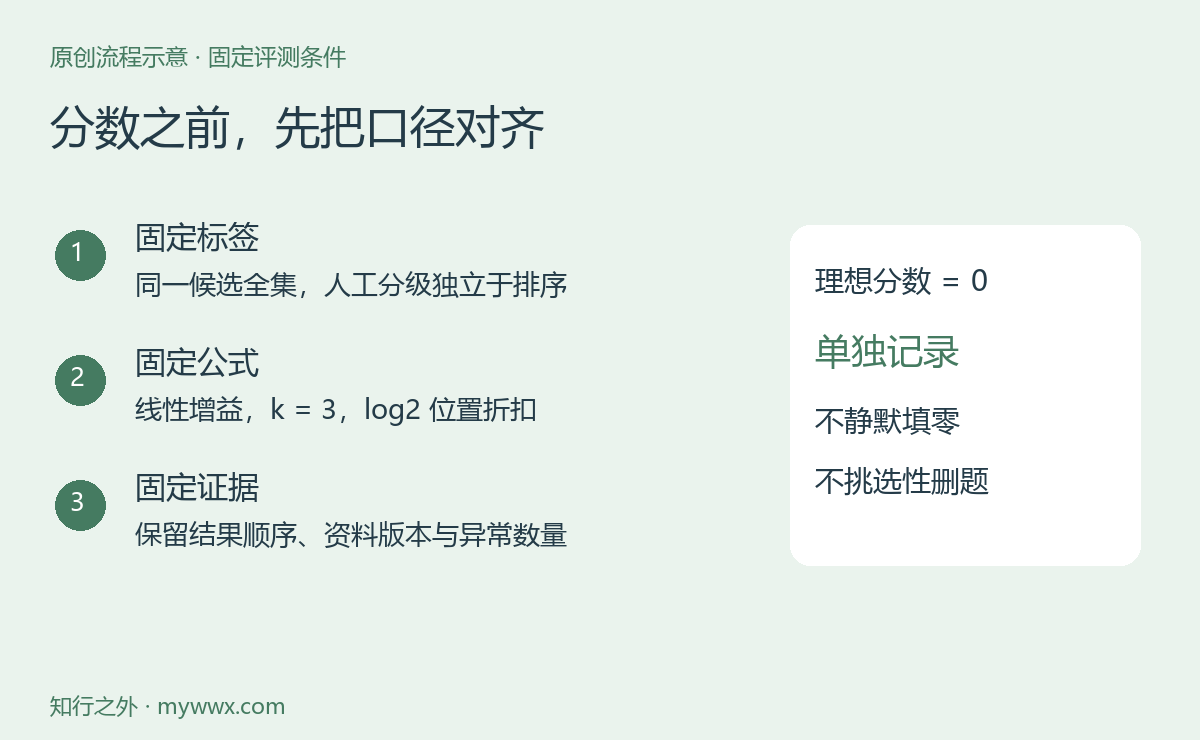
这段脚本对“候选都不相关”返回 None,提醒单独记录不可评测的问题,而不是静默填零。其他库可能有自己的约定。团队使用哪一种都要预先写清楚,并同时报告有效问题数和被排除问题数,不能选择性删掉困难问题。
六、并列分数和缺失文档怎样处理
当使用 scikit-learn 的 ndcg_score 时,真实标签和预测分数必须按同一候选顺序对齐。不能把已经排序后的标签数组和未排序的分数数组随意组合。该接口默认会处理预测分数并列;只有确定没有并列时,才考虑文档中的 ignore_ties 选项。
本文脚本计算的是一个已确定的展示顺序。若两个结果同分,产品最终可能按时间或编号决定顺序,应保存那个实际顺序。本例的资料相关性存在并列零分,不影响理想分数;需要注意的是预测分数并列与相关性相同是两个不同概念。
对于漏召回的相关资料,可以使用一个固定、充分标注的评测全集作为理想分母,漏掉的资料不贡献实际 DCG。不要只拿系统找出的前三条自行构造理想分母,否则找得差的系统也可能因为分母过小而显得很优秀。
七、从一个例子扩展到可用的评测记录
先选十到二十个真实但经过脱敏的常见问题,覆盖直接查入口、查条件、比较方案和应当拒答的情况。每个问题保存问题编号、候选资料版本、相关性标签、两个系统的完整结果顺序、k 和计算口径。规模小的时候,证据完整比小数位数多更有价值。
对每个有效问题独立计算,再按事先约定做平均。既看整体平均,也看退步最多的具体问题。平均值上升可能掩盖某一类关键需求明显变差,不能只挑几个改善案例做展示。若改变了候选集合或标注规范,应重新运行两个方案,保持比较条件一致。
建议交付三份文件:问题与标签清单、各系统的结果记录、计算报告。报告同时列出有效问题数、无相关资料问题数和异常输入数量。将本例脚本用于更大数据前,增加文件读取、字段验证与版本记录,而不是直接把网页抓取结果无检查地塞进去。
八、常见误判与下一步
如果结果超过一,先检查是否出现负数标签、重复文档、不同候选分母或增益公式混用。如果所有结果都是一,检查是不是每个排序都按自己的结果重新计算了“理想”分母。如果换 k 后分数变化很大,观察直接答案在边界的前后位置,不要只调参数追求数字变大。
NDCG 可以帮助决定是否值得进一步测试某个召回或重排序方案,但不能代替答案事实核验。生成式问答还应检查引用能否支持结论、信息是否过期以及没有证据时能否说明不知道。先把“找得到、排得好、答得对”分成三份证据,问题才容易定位。
本文离线算术与异常输入检查已运行,没有安装或测试实际重排序服务,也没有验证线上点击效果。读者完成后应能解释甲乙差别、复算分母,并明确哪些问题没有进入平均值,而不仅是记住一个缩写。


还没有公开评论,欢迎分享你的想法。