给知识库接入更多资料后,回答可能更完整,也可能把不该展示的内部内容带到不该看到的人面前。常见误解是:既然系统有登录页,或者提示词写了“不要泄密”,检索出来的资料就天然安全。实际上,登录身份、文档权限与模型回答是三个不同环节。
本文用三份虚构资料解释 RAG 中的文档级权限过滤。你会得到一份权限矩阵、一个只用 Python 的离线练习,以及从检索候选到引用链接的检查清单。它不连接真实企业系统,不实现可上线的身份认证,也不把教学代码包装成完整安全方案。
一、为什么“已经登录”还不够
登录通常回答“这个人是谁”,授权回答“这个人能读取哪一份资料”。同一家公司的两个员工都能登录,并不意味着都能看报价、人员信息或项目内部记录。搜索服务允许应用访问索引,也不等于索引内每份文档都对所有用户开放。
Microsoft 的 Azure AI Search 官方文档将文档级访问控制应用于从数据摄取到查询执行的过程,并区分了字符串安全过滤和基于身份的权限机制。前者通过查询中的用户或组标识过滤结果,字符串比较本身不是身份认证;调用者身份仍须由可信服务确定。
本文只解释通用思路,不要求开通 Azure 服务。实际产品的部分原生 ACL、标签与数据源集成仍可能处于预览阶段,应阅读对应版本限制。不能因为某个宣传页面写“支持权限”,就假定你的当前接口、数据源和套餐都已经生效。
二、先给三份资料画权限矩阵
假设一个虚构的活动团队有两类成员:普通工作人员属于 staff 组,运营负责人同时属于 staff 和 ops 两组。下面的资料内容全部是练习文字,不是真实企业数据。
- A:公开给团队的报名操作说明,允许
staff组读取。 - B:运营成本讨论记录,仅允许
ops组读取。 - C:尚未完成权限标注的内部草稿,没有有效授权组。
本例约定:组权限取并集,只要命中一项明确允许的组就可读取;没有权限元数据的资料不进入结果。普通成员应只得到 A,运营负责人可以得到 A、B,未知身份不能执行查询。
这不是所有组织的统一策略。有些系统还会有显式拒绝、部门继承、租户隔离和敏感标签。练习先把范围写小,真实接入时把这些规则另外列清楚。不能把“没有标注”自动解释成“所有人可看”。
三、文档切成段落,权限不能跟丢
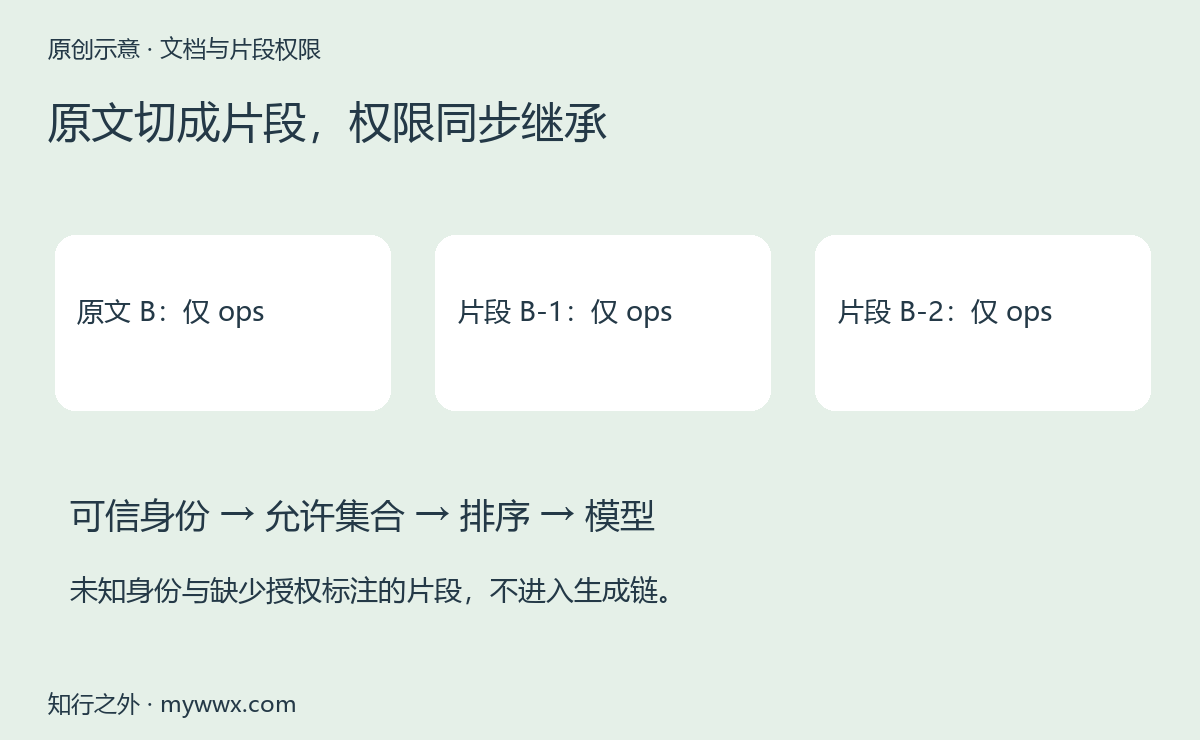
RAG 经常先把整份资料切成多个片段,再建立向量或关键词索引。如果原文 B 仅对运营负责人开放,那么 B 的各片段也需要带上对应的来源编号与权限信息。只给第一段保存权限,其余段落视为普通文本,会让后续过滤出现缺口。
为每个片段至少记录来源文档编号、片段编号、允许的组以及权限版本。正文更新与权限更新是两类变化:文件没改过,也可能因为员工调岗或分享范围改变而需要撤销访问。不能只在内容改变时同步权限。
如果同一份资料被复制到多个索引,检查每个副本是否都有相同的访问语义。开发、测试环境也不要随意混入真实内部正文;判断一个系统能否安全接入资料,需要真实的数据流和权限流程检查,不能只看某个过滤函数存在。
四、过滤应该发生在哪里
理想的数据流是:可信服务确定调用者身份与组,查询只在允许的资料范围内产生候选,然后对允许的候选排序,最后才向模型提供必要片段。不能先把全部内部资料送给模型,再请求模型自行隐藏无权内容。
也不要把“先取全局前三条,再在页面上隐藏无权结果”视为同样的方案。这不仅可能导致可用结果不足,还可能让无权资料进入重排序、调试日志、摘要或其他中间环节。最终界面不显示,不证明前面的处理链没有暴露。
在支持过滤的检索服务中,应按官方接口把过滤条件与查询绑定。某些产品的过滤与向量搜索执行方式存在具体差异,需要阅读其说明,不能直接照抄另一个产品的参数。本例不提供云端参数,只用小数组演示“允许集合先行”的顺序。
五、运行一个最小离线例子
建立空目录 rag-access-lab,确认 python --version 可用,把下面代码保存为 access_demo.py,执行 python access_demo.py。代码中的身份字典是测试夹具,不能替代登录系统;这里也没有真实向量检索和模型调用。
documents = [
    {"id": "A", "groups": {"staff"}, "text": "报名操作说明", "score": 0.7},
    {"id": "B", "groups": {"ops"}, "text": "运营成本讨论", "score": 0.9},
    {"id": "C", "groups": set(), "text": "未标注草稿", "score": 1.0},
]
identities = {"reader": {"staff"}, "owner": {"staff", "ops"}}

def visible_results(principal, docs, limit=3):
    if principal not in identities:
        raise PermissionError("身份未通过练习夹具确认")
    if type(limit) is not int or limit < 1:
        raise ValueError("结果条数须为正整数")
    groups = identities[principal]
    allowed = []
    for doc in docs:
        acl = doc.get("groups")
        if not isinstance(acl, set) or not acl or not (groups & acl):
            continue
        allowed.append(doc)
    return sorted(allowed, key=lambda d: d["score"], reverse=True)[:limit]

for principal in ["reader", "owner"]:
    rows = visible_results(principal, documents)
    print(principal, [row["id"] for row in rows])
预期输出是 reader ['A'],以及 owner ['B', 'A']。C 的示例相关性分数最高,但没有授权,仍不应该出现在结果里。B 对普通成员无权,分数更高也不能改变这个事实。
注意调用者不能在请求正文里任意填写“我是 owner”。生产服务必须从已验证的会话或身份凭据得到主体,再从可信授权关系得到组信息。这里把身份写成文字,只是为了让读者看清输入、判断和输出,不是设计一种无密码访问方式。
六、把反向案例也测出来
只验证负责人能看到 B 还不够,还要验证普通成员看不到 B。增加以下断言,明确你正在检查哪条规则:
assert [x["id"] for x in visible_results("reader", documents)] == ["A"]
assert [x["id"] for x in visible_results("owner", documents)] == ["B", "A"]
assert visible_results("reader", [documents[1], documents[2]]) == []

try:
    visible_results("unknown", documents)
except PermissionError:
    pass
else:
    raise AssertionError("未知身份不能被当作普通成员")
再复制一份 B 的片段,暂时删除它的 groups 字段,确认结果仍不包含这份缺少标注的片段。这能检查“缺元数据默认放行”的错误,但不能证明真实索引的数据同步已经正确。
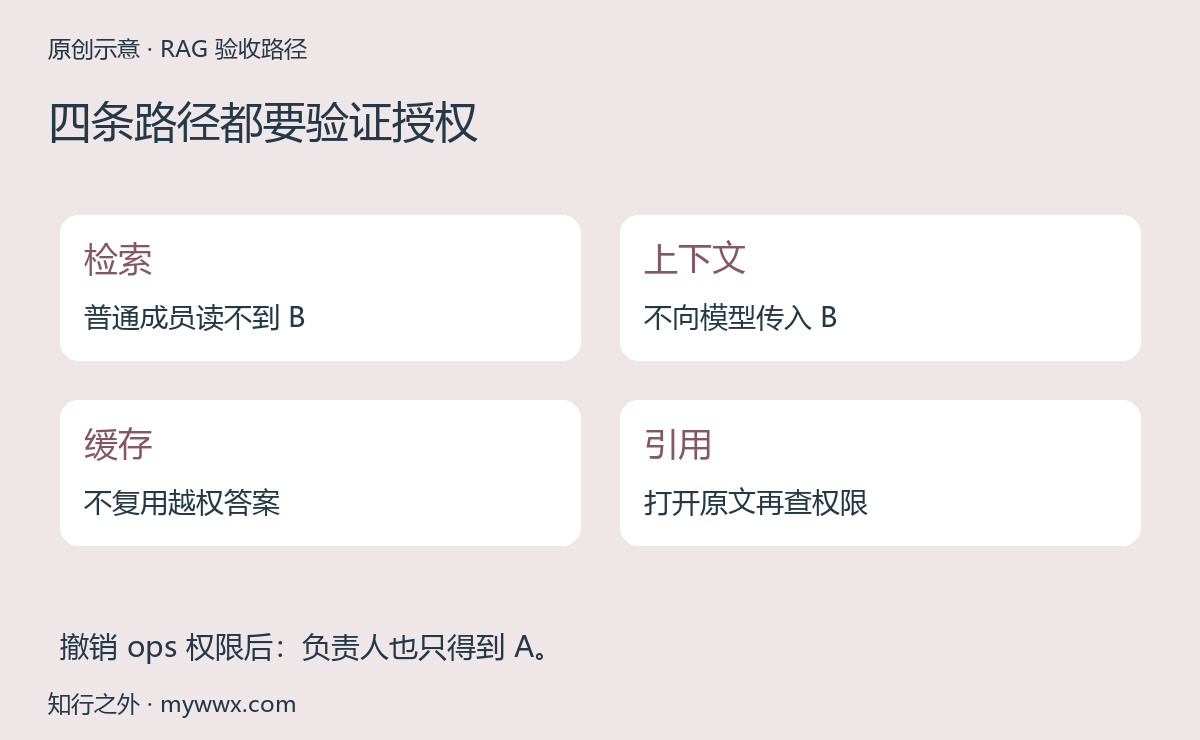
最后模拟撤权:把测试身份 owner 的组改为只有 staff,重新查询应只得到 A。修改后恢复练习夹具,避免后续结果混乱。这个动作说明权限变化需要影响新查询;如果系统仍返回旧结果,要继续检查缓存与身份信息更新。
七、缓存和引用也有权限边界
把“同一个问题”的回答给所有人复用,是常见的缓存误区。负责人询问活动成本得到的答案,不能仅凭问题文字相同,就复用给普通成员。缓存设计需要考虑租户、主体或等价授权范围,以及权限变更后的失效机制。
同样要检查模型上下文、检索摘要、引用标题和调试日志。即使不展示正文,标题“某项目内部成本方案”也可能透露本不应公开的信息。日志应遵循实际需要和访问限制,不能为了调试方便永久保留所有检索片段。
引用链接必须在打开原文时再次执行相应授权。知道链接地址或文档编号,不应该成为读到资料的唯一条件。如果对象存储、文件预览和搜索系统分别管理,不能只测试搜索页,忽略直接访问预览地址的路径。
八、从教学例子到实际验收
准备至少四类测试身份:普通成员、特定项目成员、管理人员和未登录请求。每份样本资料标明允许与不允许的身份,用虚构内容先验证正反案例。记录每个步骤实际看到的资料编号,而不是只检查最后回答里有没有某个关键词。
实际系统还要覆盖新成员入组、移出组、资料改分享范围、索引延迟、缓存过期和多租户同名组等情况。每个测试都应写清预期与失败处理,不能把暂时没有返回内容解释成授权已经正确。
若缺少可信身份或权限元数据,先停止把敏感资料接入生成链。可以继续用公开材料验证检索与提示词,但不能用“模型答应不说”代替访问控制。本文自编数组练习已验证允许、拒绝、缺失标注与撤权,不涉及真实身份平台、云端索引或生产安全测试。
九、保留一份能复核的验收记录
每条测试记录写下测试身份、授权组、资料编号、权限变更动作和预期可见集合。执行后再补实际返回编号及差异,不复制敏感正文到公共工单。失败时先查身份解析,再查授权同步、索引片段和缓存,避免反复修改提示词掩盖真正问题。
上线前还要指定谁负责权限维护、谁能批准例外、撤权最长需要多久生效。教学断言通过,只代表这份固定输入上的判断符合约定;真实业务是否满足要求,要由系统负责人按实际数据流与风险完成验收。


还没有公开评论,欢迎分享你的想法。